التكنولوجيا
تنشر Ramen الشفرة المصدرية لـ Aura Autopilot لإتاحة اختبار الألعاب بالذكاء الاصطناعي على Unreal Engine وUnity وGodot

 أضف Gaming.net إلى مصادرك المفضلة على Google
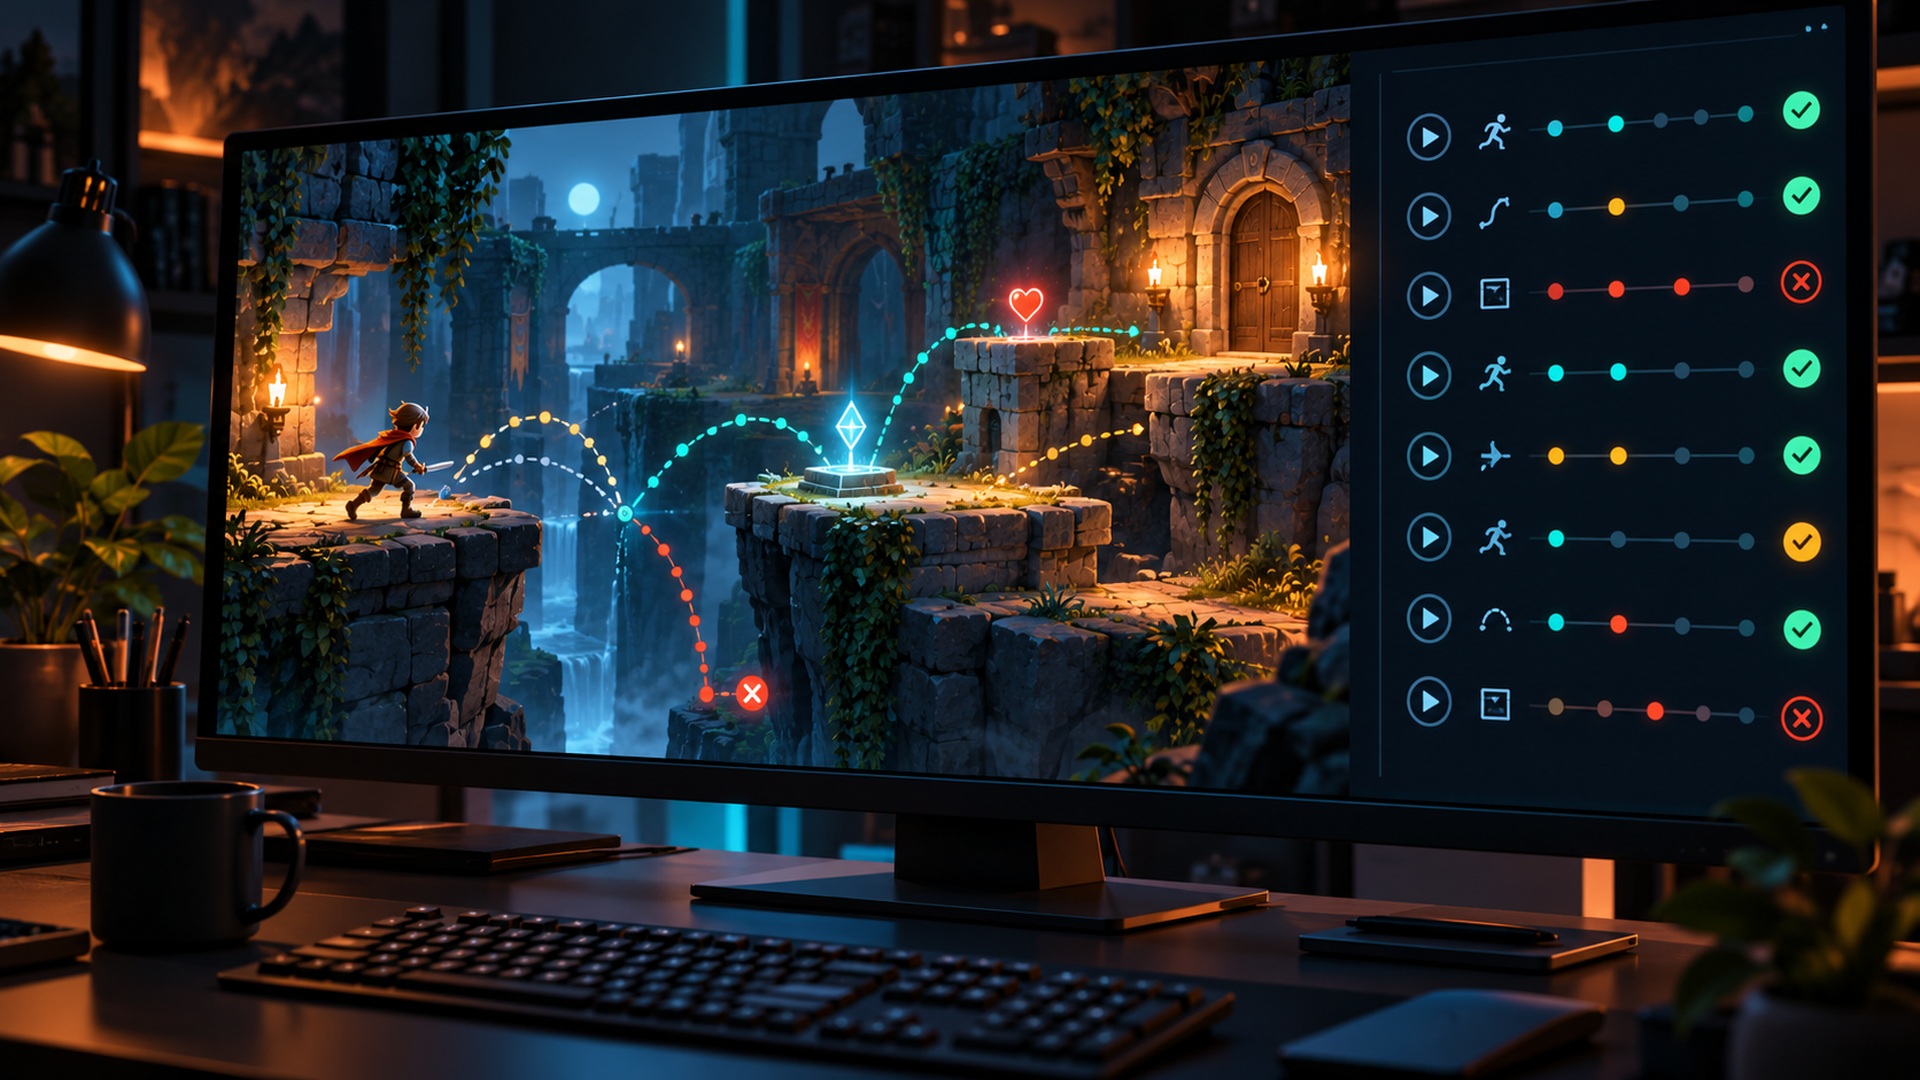
قد تُجمَّع اللعبة دون أخطاء، ومع ذلك قد تتعطل فيها القفزات، أو يتعذر الوصول إلى أحد الأهداف، أو تبقى إحدى القوائم مفتوحة ولا تُغلق أبدًا. وتسعى Ramen إلى سد هذه الفجوة من خلال Aura Autopilot، وهو وكيل مفتوح المصدر للعب الألعاب أُعلن عنه في 30 أكتوبر للعمل على Unreal Engine وUnity وGodot. وصُممت الأداة لتتعلم اللعبة أثناء اللعب، وتسعى إلى تحقيق أهداف طويلة الأمد، وتتيح للمطورين توجيه اهتمامها إلى أنظمة بعينها.
يوسّع هذا الإعلان نطاق Aura، مساعد التطوير الحالي متعدد الوكلاء من Ramen لمنصتي Unreal وUnity. ويجمع سير العمل المقترح بين نشاطين غالبًا ما يظلان منفصلين: يبني أحد الوكلاء ميزة في أسلوب اللعب، ثم يدخل وكيل آخر إلى اللعبة لاختبار ما إذا كانت الميزة تعمل فعلًا. وتكمن أهمية ذلك بالنسبة إلى استوديوهات الألعاب في تقصير دورة تلقي الملاحظات والاستجابة لها، دون أن يضطر المطور إلى تكرار كل تفاعل أساسي بنفسه بعد كل تغيير.
لماذا يضيف اللعب الفعلي ما لا تستطيع فحوصات الشفرة البرمجية تقديمه
يثبت التجميع أن الشفرة البرمجية تستوفي قواعد اللغة البرمجية. لكنه لا يثبت أن اللاعب يستطيع إكمال مهمة، أو أن شريط القدرة على التحمل ينخفض بالمعدل المطلوب. وتعتمد هذه النتائج على تفاعل الأنظمة بمرور الوقت، بما فيها المدخلات والفيزياء والرسوم المتحركة وحالة اللعبة وعناصر الواجهة، وأحيانًا عدة لاعبين متصلين.
توضح وثائق Ramen الخاصة بوكيل التحقق الحالي في Aura هذا الفرق بصورة ملموسة. ففي Unreal، يشغّل الوكيل وضع اللعب داخل المحرر، ويفحص معلومات وقت التشغيل، مثل الكائنات التي جرى إنشاؤها وخصائص القدرات وعناصر الواجهة الظاهرة، ويمكنه إرفاق مقطع فيديو مسجل بوصفه دليلًا. كما يمكنه محاولة إصلاح المشكلة وإعادة التحقق. أما التنفيذ الموثق في Unity فأبسط: إذ يجمّع الشفرة، ويدخل وضع اللعب، ويفحص لقطات الشاشة، من دون ميزات أدلة الفيديو المتقدمة نفسها.
Autopilot هو وكيل اختبار اللعب الذي أُعلن عنه حديثًا، لذا توفر هذه القدرات الحالية سياقًا لفهمه، لا دليلًا على تطابق وظائفه في جميع محركات الألعاب. وتقول Ramen إن Autopilot قادر على اللعب في ألعاب التصويب، وألعاب تقمص الأدوار والحركة، وألعاب الهواتف المحمولة، وألعاب البقاء وصناعة الأدوات، وألعاب تقمص الأدوار اليابانية القائمة على الأدوار، وألعاب الاستراتيجية في الوقت الحقيقي. وهذا ادعاء بشأن تنوع العروض التوضيحية الأولية، وليس دليلًا على أن الوكيل سيعمل دون تعديل مع كل لعبة تجارية أو كل نظام تحكم غير مألوف.
القدرة على توجيه الاختبارات أهم من فوز الذكاء الاصطناعي في عرض توضيحي
يحتاج وكيل لعب الألعاب المفيد لفرق التطوير إلى ما هو أكثر من اجتياز مستوى؛ إذ ينبغي أن يتحرى السلوك الذي يهم المطور. وتصف Ramen Autopilot بأنه قابل للتوجيه، ما يتيح للفريق تركيزه على نظام بعينه بينما يخطط لتحقيق أهداف طويلة الأمد.
لنتأمل تغييرًا افتراضيًا في نظام المخزون. فقد يتطلب الاختبار المجدي العثور على غرض والتقاطه وفتح المخزون وتجهيزه، ثم التحقق من تغير سلوك الشخصية. وتقدم هذه الخطوات المتتابعة معلومات أكثر من مجرد ظهور نافذة المخزون. كما تتيح فرصًا عدة لحدوث إخفاق قد يفوت فحصًا برمجيًا ضيق النطاق.
ومن الناحية العملية، سيحتاج المطورون إلى كتابة أهداف واضحة وشروط محددة للقبول. فعبارة «اختبر المخزون» تترك مجالًا واسعًا للتأويل. أما عبارة «التقط هذا الغرض وجهّزه وتأكد من تغير قيمة الضرر» فتمنح الوكيل نتيجة يمكن ملاحظتها. ولا تزال الفرق بحاجة إلى أدلة توضح ما جرت محاولته وما حدث؛ فرسالة نجاح سلسة الصياغة وحدها لا تكفي.
ما الذي يثبته وصف «التحسين الذاتي» وما الذي يتركه دون حسم
قال آندي تسن، الرئيس التنفيذي والمؤسس المشارك لـRamen، في الإعلان: «تلعب Aura Autopilot أي لعبة في الوقت الفعلي وتتعلم أثناء اللعب، ويتحسن أداؤها كلما لعبت أكثر. وهذا يفتح آفاقًا جديدة لاختبار ضمان الجودة في الألعاب، ونحن ننشر شفرته المصدرية مفتوحةً كي يتمكن المطورون والباحثون من تطويره».
تصف Ramen الوكيل بأنه يتحسن ذاتيًا بصورة متكررة، وتقول إنه يقدم النتائج بسرعة أكبر كلما اكتسب خبرة في اللعبة. ولا يحدد الإصدار ما إذا كان هذا التحسن ناتجًا عن ذاكرة دائمة، أو استراتيجيات منقحة، أو أدوات مولّدة، أو تدريب النموذج، أو مزيج من هذه العوامل. وتترتب على كل آلية من هذه الآليات آثار مختلفة على قابلية إعادة إنتاج النتائج والتكلفة ومدى احتفاظ الوكيل بما تعلمه بعد تحديث كبير للعبة.
قد يكون نظام الاختبار القادر على التكيف مفيدًا عند تغير الأهداف والبيئات، لكن التكيف يجعل أيضًا مقارنة جولات الاختبار أكثر تعقيدًا. وينبغي للاستوديوهات التي تقيّم الأداة أن تحتفظ بنسخة اللعبة وإعدادات النموذج والهدف وظروف البدء إلى جانب النتيجة. ويسهّل ذلك التمييز بين خلل ثابت وسلوك ناتج عن سلوك مسار مختلف عبر المستوى.
المصدر المفتوح يفصل طبقة الاختبار عن مزود نموذج واحد
تقول Ramen إن إصدار Autopilot المستقل يعمل مع اشتراكات Claude Code وCodex الحالية، أو باستخدام مفتاح API خاص بالمطور. كما يجري دمجه في اشتراكات Aura. ويوفر مشروع GitHub المُعلن عنه للاستوديوهات والباحثين مكانًا لفحص طبقة الاختبار وتوسيعها، بدلًا من مطالبة كل فريق ببناء هذه البنية التحتية بصورة مستقلة.
قد تتيح هذه المرونة للاستوديوهات مقارنة النماذج بألعابها واختيار التوازن المناسب بين زمن الاستجابة والموثوقية والتكلفة. وقد يتعامل نموذج سريع جيدًا مع التفاعلات البسيطة، لكنه قد يواجه صعوبة في تحقيق هدف يتطلب تذكّر عدة قرارات سابقة. وقد يحسّن نموذج أكثر قدرة معدلات إتمام المهام، مع زيادة تكلفة تكرار التشغيل. ولا يعني إتاحة الشيفرة المصدرية مفتوحةً أن رسوم استخدام النماذج أو القدرة الحاسوبية اللازمة لتشغيل اللعبة ستزول.
ومن المهم أيضًا التمييز بين Autopilot ومنتج Aura الأوسع نطاقًا. يذكر الإعلان أن وكيل الاختبار يدعم Unreal وUnity وGodot، في حين يظل مساعد التطوير الأوسع في Aura مخصصًا لـ Unreal وUnity. ولا ينبغي اعتبار دعم Autopilot لـ Godot ادعاءً بأن جميع أدوات الإنشاء في Aura أصبحت متاحة الآن على Godot.
قراءة ادعاءات الأداء في سياقها
تقول Ramen إن Autopilot يعمل أسرع بثلاث مرات من وكيل التحقق السابق لديها، وبتكلفة أقل، وتذكر أن نتائجه في اختبار الألعاب تتفوق على Bezi وNeoStack وClaude Code وCodex. وتعتزم الشركة إصدار ورقة بيضاء مرافقة تتناول البنية والمعايير المرجعية.
هذه الأرقام صادرة عن الشركة. ولا تتضمن المواد التمهيدية المقدمة لهذا المقال المنهجية الكاملة للمعايير المرجعية، أو مجموعة المهام، أو إصدارات النماذج، أو معايير تحديد الإخفاق، أو حسابات التكلفة. لذلك، لا تثبت النتائج تفوقًا شاملًا في سير العمل لدى كل استوديو. ومن شأن تقييم مفيد في بيئة الإنتاج أن يقارن بين إتمام الاختبارات بنجاح، والعيوب التي لم تُكتشف، والإنذارات الكاذبة، ووقت التشغيل، والتكلفة الإجمالية للنماذج، وذلك باستخدام الإصدارات نفسها.
التكرار الأسرع لا يغني عن ضمان الجودة البشري
قد يجعل اختبار الألعاب آليًا عمليات التحقق المتكررة في متناول الفرق الصغيرة، ويمنح الاستوديوهات الأكبر طريقة أخرى لاختبار الإصدارات المتغيرة. ويكون ذلك جذابًا بوجه خاص عندما يلزم تكرار التسلسل نفسه بعد إجراء تغييرات صغيرة عديدة. لكنه أقل ملاءمة للحكم على مدى إمتاع القتال، أو مدى ترحيب البرنامج التعليمي باللاعب، أو الأثر العاطفي لمشهد قصصي.
توسّع Ramen أدوات الإنشاء بالتوازي مع الاختبار؛ إذ يشمل الإعلان تكاملات مع Figma وBlender، وتحريك الشخصيات استنادًا إلى الأوامر النصية، ووكيلًا مُحدّثًا لتصميم المستويات وإنشاء مساحات أولية أكبر. ويزيد إنشاء المحتوى بوتيرة أسرع من أهمية التحقق من التفاعلات الناتجة. ولا تقتصر قيمة دورة الإنشاء والاختبار على إنتاج مزيد من الأصول، بل تتمثل في اكتشاف الأخطاء قبل أن يصبح فك تشابك تلك الأصول والأنظمة أصعب.
تساعد خلفية Ramen على تفسير هذا التوجه. فقد أنشأ الاستوديو السابق المتخصص في الواقع الافتراضي لعبة Zenith قبل انتقاله إلى أدوات المطورين، ويقول إن استحواذه على Coplay في عام 2026 عزز قدرات Aura في Unity. ويبرز Autopilot هذه الاستراتيجية بوضوح أكبر: فالذكاء الاصطناعي الذي يساعد على إنشاء لعبة يحتاج أيضًا إلى وسيلة موثوقة لفحص اللعبة التي أنشأها. أما بالنسبة إلى اللاعبين، فستتمثل الفائدة المحتملة في تقليل التفاعلات المعطوبة التي تصل إلى الإصدار، لا في الاستغناء عن الأشخاص الذين يحكمون على مدى استحقاق التجربة للعب.